はじめに
Kubernetes の Pod は、アプリの都合と関係なく止められます。ローリングアップデート、ノードのドレイン、Karpenter の Consolidation、Spot インスタンスの回収。どれも Pod から見れば、既定では「SIGTERM が届き、猶予期間が過ぎたら SIGKILL」という同じ出来事です。
この記事の結論は 2 つです。
- アプリは、プラットフォームが防げない Disruption を前提に設計する。止まる前提で終了コードまで決め、二重実行されても壊れないよう冪等にする
- PDB(PodDisruptionBudget)や Karpenter の
karpenter.sh/do-not-disrupt(以下 do-not-disrupt)による、プラットフォーム側の保護は最小限にする。保護しすぎるとノードが空かなくなり、使っていない分のノードのコストまで払い続けることになる
kind で実際に Pod を止めて確かめたところ、ワーカー向けの停止処理を Job でそのまま使うと、podFailurePolicy を設定した場合に、未完了の仕事が「完了」として扱われてしまうことがわかりました。Kubernetes はドキュメントどおりに動いていて、原因はアプリ側の終了コードにあります。
なお、この記事は調査・検証環境での実験・事実確認・図の作成に AI(Claude)を使い、AI が書いた下書きを僕が校正する形で執筆しています。
想定読者
- Kubernetes を運用する SRE・プラットフォームエンジニアで、アプリ側に「Pod が止められても壊れないようにしてほしい」と伝える立場の人
- Go で書いたワーカーや Job を Kubernetes に載せていて、
SIGTERMの扱いをひととおり書いたことがある人 - Karpenter を入れた、または入れる予定で、Consolidation が何を止めるのかを知りたい人
Pod や Deployment の基本は説明しません。
用語と
用語は Kubernetes 公式ドキュメント日本語版に合わせます。Disruption は公式でも訳さずに使っているので、そのまま書きます。
| 表記 | 指すもの |
|---|---|
| 自発的なDisruption | 誰かが意図して Pod を止めること |
| 非自発的なDisruption | 障害など、避けられないもの |
| 退避 | Eviction API や kubelet による Pod の追い出し |
| Job | Job リソース。仕事の単位はタスクと呼ぶ |
検証には kind v0.33.0(Kubernetes v1.37.0)、Go 1.27.3、otelcol-contrib 0.164.0 を使いました。AWS 版の Karpenter(実際の EC2 や Spot を使うもの)は kind では動かせません。そのため Karpenter の挙動は、ドキュメント(v1.15)と実装を根拠にしています。ただし、PDB・do-not-disrupt・NodePool の disruption budget が Consolidation を止めることと、terminationGracePeriod の上限で削除された Pod に DisruptionTarget が付かないことは、KWOK v0.8.0(ノードをシミュレーションして Karpenter を動かす仕組み)と Karpenter v1.15.1 で検証しました。
Disruption は
Pod を止める要因を、PDB と do-not-disrupt で防げるかどうかで整理します。
| 発生源 | 種類 | PDB | do-not-disrupt |
|---|---|---|---|
| ローリングアップデート | 自発的 | 対象外 | 対象外 |
kubectl drain | 自発的 | 防げる | 対象外 |
| Consolidation | graceful | 防げる | 防げる |
| Drift | graceful | 条件付き | 条件付き |
| Expiration | forceful | 始まりは防げない | 始まりは防げない |
| Spot の回収 | forceful | 始まりは防げない | 始まりは防げない |
| ハードウェア障害 | 非自発的 | 防げない | 防げない |
Consolidation から Spot の回収までの 4 行は、Karpenter が起こす、または扱う Disruption です。「種類」の列は Karpenter 自身の分類です。Spot の回収そのものは EC2 が起こします。Karpenter は、Interruption の処理(--interruption-queue)を有効にしている場合に、通知を受けて先回りでドレインします。Karpenter は自動で起こす Disruption を graceful と forceful に分けます(手動のノード削除は別扱い)。graceful は NodePool の disruption budget で流量を制限できます。forceful は、期限切れ(Expiration)や Spot の回収通知(Interruption)をきっかけにすぐドレインを始めます。こちらには budget も効きません 1 。
表の「始まりは防げない」は、PDB も do-not-disrupt も forceful の開始は止めないという意味です。始まったドレインは、PDB や do-not-disrupt の Pod があれば、その退避を待ちます(NodePool に terminationGracePeriod があれば、その上限まで)。ただし Spot は 2 分前の通知(best effort)のあと回収されるので、ドレインが終わっていなくてもインスタンスは止まります 2 。Drift の「条件付き」は、NodePool に terminationGracePeriod を設定していると、PDB や do-not-disrupt の Pod があっても Drift で止められるという意味です。
Karpenter 以外の行も補足します。ローリングアップデートの流量は Deployment の maxUnavailable と maxSurge で決まり、PDB は効きません。do-not-disrupt は Karpenter の annotation なので、Karpenter 以外の行には効きません。
表の中でも Consolidation は、コストを下げるためにプラットフォーム自身が起こす Disruption です。
ここから導ける前提は 1 つです。アプリの正常性を、プラットフォーム側の保護に依存させない。PDB などで防げる Disruption を実際に防ぐかどうかは、あくまでプラットフォーム側の判断です。
アプリ側の
猶予期間は
実測に使ったサンプルは、signal.NotifyContext で受けた SIGTERM をループの先頭で確認し、新しいタスクは取らず、処理中のタスクは最後まで終わらせる作りです。
ctx, stop := signal.NotifyContext(context.Background(), syscall.SIGTERM, syscall.SIGINT)defer stop()
for taskID := 1; ; taskID++ {    select {    case <-ctx.Done():        slog.Info("signal received, not taking new tasks")        slog.Info("exiting cleanly")        return    default:    }    processTask(ctx, taskID, taskDuration)}
これを terminationGracePeriodSeconds: 20、preStop で 5 秒 sleep する Pod として動かし、30 秒かかるタスクの途中で Pod を削除しました。アプリが SIGTERM のあとに使えたのは約 15 秒で、削除から約 20 秒で SIGKILL(終了コード 137)されています。
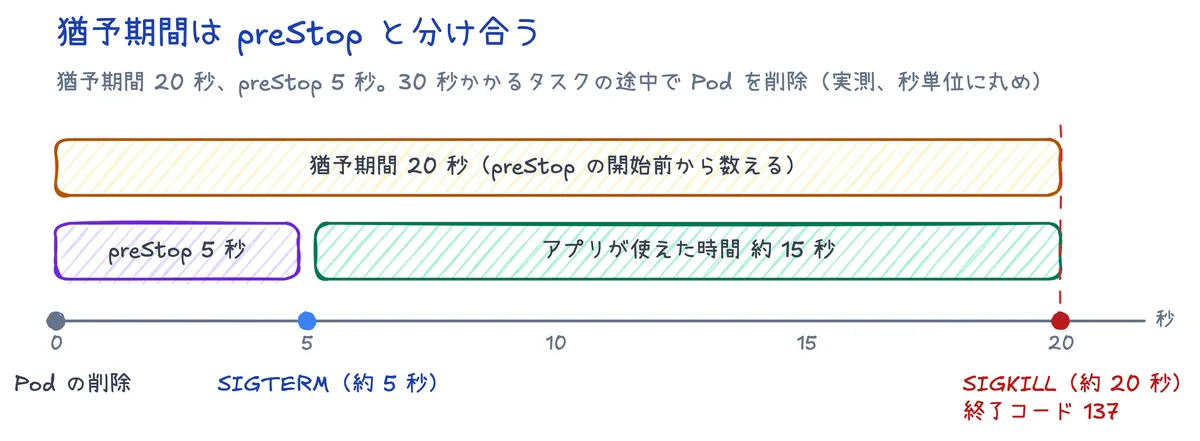
猶予期間のカウントダウンは preStop の前に始まるので 3 、preStop の 5 秒はアプリの持ち時間から差し引かれます。「preStop の時間 + アプリの最大処理時間 < 猶予期間」になるよう、予算を先に決めておきます。
HTTP サーバーでは http.Server.Shutdown を使います。ただし Shutdown は、WebSocket のように hijack された接続を待たないので、これらは別に閉じます 4 。
Job の
ワーカーは無限ループなので、SIGTERM で抜けて終了コード 0(成功)を返すのが自然です。退避された Pod は Deployment が終了コードを見ずに作り直すので、ワーカーはそれで構いません。ただ、同じ終わり方を Job に使うと問題が起きます(後の「Job:止められたら 0 以外で終わる」で実測します)。Job では、仕事を終えずに止まるときに終了コードを 0 以外(失敗)にするのが、アプリ側の責務です。
case <-ctx.Done(): slog.Info("signal received, not taking new tasks") if taskCount > 0 { // podFailurePolicy を設定した Job では、未完了のまま 0 で抜けると成功と判定されてしまう。 // os.Exit は defer を実行しないので、後片付けが要るならここより前で済ませる。 slog.Info("exiting before all tasks done", "doneTasks", taskID-1) os.Exit(1) }podFailurePolicy の onExitCodes で特定の値を扱わない限り、Job が見るのは 0 か 0 以外かだけです。Go の os.Exit は移植性のために 0〜125 の値を勧めているので、その範囲の 1 にしました。os.Exit は defer を実行しないので、後片付けは呼ぶ前に済ませます 5 。
二重実行は
8 秒のタスクで試した別の実行では、猶予期間とは別の問題も見えました。ループの先頭で確認した時点ではシグナルが届いておらず、タスク 1 を終えてタスク 2 を取った直後に SIGTERM が届いていたのです。
07:15:58 INFO task finished taskID=107:15:58 INFO task started taskID=207:15:58 INFO SIGTERM observed during task, draining taskID=2確認とシグナル到着のあいだの隙間は、Go の書き方を工夫しても無くせません。猶予期間内に終わらなければ、タスク 2 は途中で止まるので、再実行される前提で設計しておく必要があります。Kubernetes の側にも、二重実行が起きる場面があります。
- Deployment のローリングアップデートは、既定で最大 125% の Pod を同時に動かす
- CronJob は同じ時刻に Job を 2 つ作ることがあり、ドキュメントは Job を冪等にすべきとしている 6
- Job は
parallelism・completionsを 1 にしても、同じプログラムが 2 回起動されることがある 7
だから二重実行は起きる前提で、冪等性で受け止めます(冪等性キーの考え方は Hono の冪等性ミドルウェアの記事 と同じです)。ロックを使うのは、冪等にできない副作用に限るのがよいと思います。
ロックの代表例は leader election です。ただ、client-go のドキュメントは、リーダーが同時に 1 つだけであることは保証しないと明記しています 8 。そこで使うのが fencing token です。ロックを取るたびに増える番号を書き込みに添え、書き込み先はそれより古い番号の書き込みを拒否します 9 。
ワークロード別の
ワーカー:ack は
ワーカーでは、手動で ack し、ack されなかったメッセージを再配信するキューを使います。ack を処理の完了後に返せば、途中で止まったメッセージはキューに戻り、別のワーカーが改めて処理できます。受け取った時点で自動的に ack する設定では止まった時点のメッセージが失われるので、手動 ack が前提です。そのぶん同じメッセージが 2 回処理されうるので、処理は冪等にします。
Job:止められたら
Job では事情が変わります。ノードをドレインして Job の Pod を退避させ、podFailurePolicy が無い Job と有る Job で結果を比べました。タスクは 15 秒 × 3 件で、アプリは処理中のタスクを終えてから終了コード 0 で抜けます。
podFailurePolicy: rules: - action: Ignore onPodConditions: - type: DisruptionTarget今回の退避では、Pod に condition DisruptionTarget(reason EvictionByEvictionAPI)が付きました 10 。Ignore を指定すると、この condition が付いて失敗した Pod は backoffLimit に数えられず、Job は代替 Pod を作ります。
| podFailurePolicy 無し | podFailurePolicy 有り | |
|---|---|---|
podReplacementPolicy の既定値 | TerminatingOrFailed | Failed |
| 退避後の Job | failed=1、代替 Pod を作成 | Complete(succeeded=1) |
ポリシー有りの Job は、3 件のタスクを終える前に止められたのに Complete になりました。podFailurePolicy が有る Job では、コントローラーは Pod が最終状態になるまで待ち、終了コード 0 なら成功とみなすためです。ポリシー無しでは、終了中の Pod をその時点で失敗と数えます 7 。Ignore のルールが評価されるのは、失敗した Pod だけです。アプリを、未完了なら終了コード 1 で終わるように直すと、Job は backoffLimit を消費せずに代替 Pod で続きました。
podFailurePolicy を効かせるには、アプリが「止められたら 0 以外で終わる」責務を果たす必要があります。
ただし、Ignore が効くのは DisruptionTarget が付いた失敗だけです。kubectl delete pod で消した Pod には condition が付かないので、0 以外で終わると backoffLimit を 1 消費します。Karpenter が terminationGracePeriod の上限や Node Auto Repair で行う強制削除も同じです。Karpenter の実装は、通常の退避には Eviction API を使います。一方、強制削除では Pod を直接消すので、condition は付きません 11 。そのためアプリの失敗として数えられます 12 。Karpenter が削除の前に condition を付ける提案は、2026 年 10 月時点で未対応です 13 。
逆に、ノードのメモリ不足などで kubelet に退避された Pod(reason TerminationByKubelet)には condition が付きます。アプリ側に原因があってもその失敗は Ignore され、activeDeadlineSeconds の期限まで作り直しが続くことがあります 10 。
ポリシー無しの Job では、別の問題も起きていました。旧 Pod と代替 Pod が、同じタスク 1 を 1 秒だけ同時に処理していました。
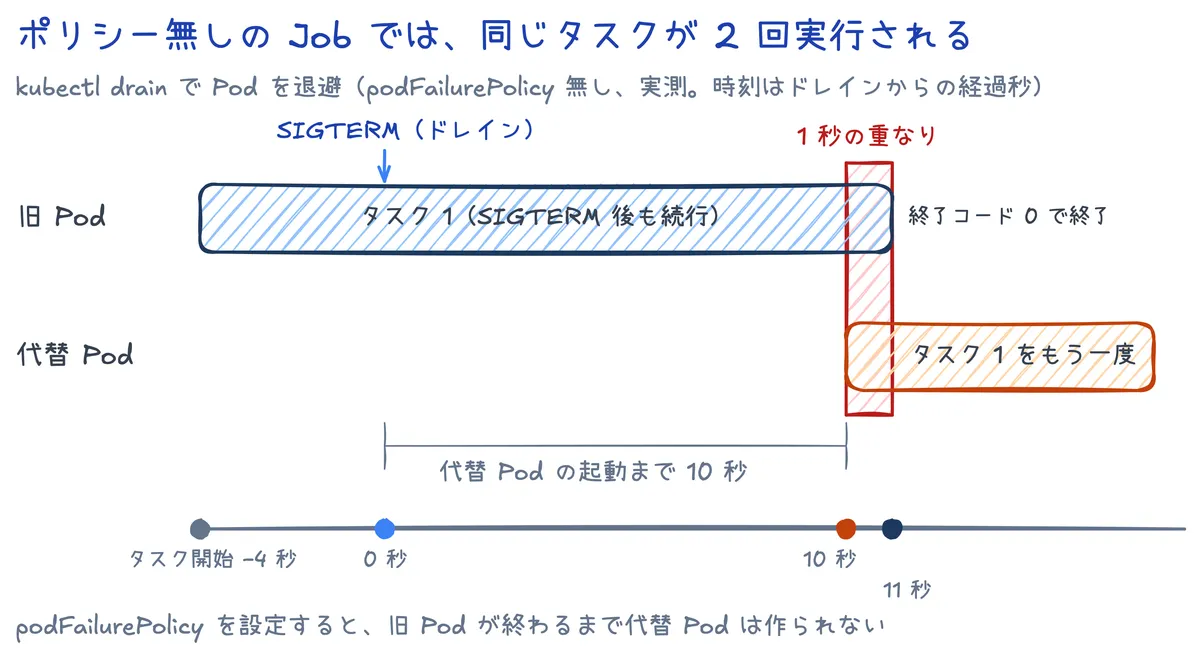
代替 Pod が起動したのは退避の 10 秒後で、Job の失敗時バックオフの初回(10 秒)と一致します。ポリシー有り(podReplacementPolicy: Failed)では旧 Pod が最終状態になるまで代替 Pod を作らないので、同時実行は起きませんでした。
Job の
.spec.activeDeadlineSeconds は Job 全体の実行時間の期限で、Pod を何度作り直しても通算で数え、backoffLimit より優先されます 7 。期限 20 秒で試すと、Job の startTime のちょうど 20 秒後に DeadlineExceeded となりました。Pod は SIGKILL ではなく SIGTERM で止まり、アプリは処理中のタスクを終えてから終了コード 1 で終わっています。
期限は、再実行を含めた全体の打ち切り時刻です。再実行するかどうかを決めるのは backoffLimit と podFailurePolicy で、Ignore で Disruption を backoffLimit に数えない設定なら、退避が続くかぎり期限まで作り直しが続きます。期限には、次の図の時間がすべて入ります。
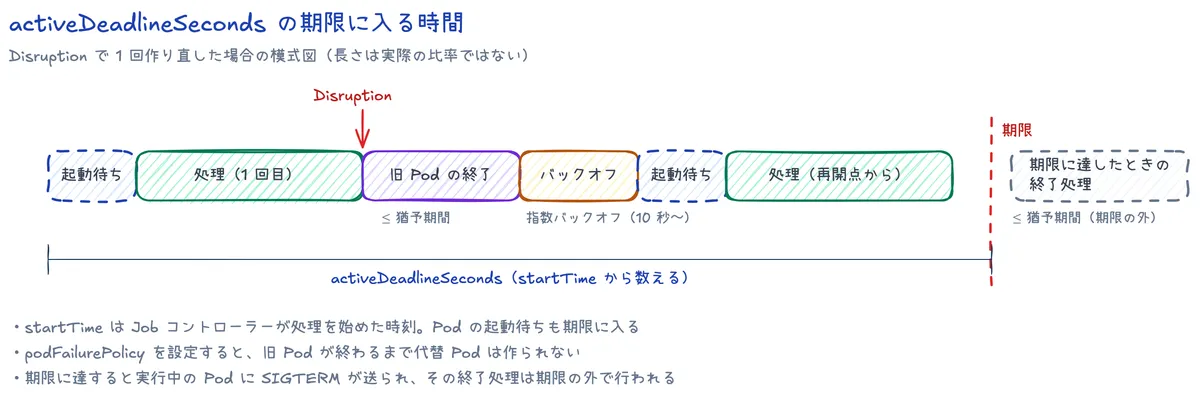
startTime は Job コントローラーが処理を始めた時刻なので、Pod の起動待ちも期限に入ります 14 。Karpenter がノードを起動する待ち時間も、同じく入ると考えられます。podFailurePolicy を設定した Job が Disruption で作り直されるときは、旧 Pod が終わるまで代替 Pod が作られないので、旧 Pod の終了処理も期限を消費します。バックオフの遅延も同じです。Job コントローラーの実装は、Ignore した失敗もバックオフの回数に数えています 15 。同じ挙動は Issue でも報告されていますが、修正されないまま閉じられています 16 。
一方、期限に達したときの終了処理は期限の外です。実測でも、期限に達したあと、処理中だったタスクを終えるまでの 10 秒をかけて Pod が終わっていました。
そのため期限の目安は、「(起動待ち + 処理時間)×(再実行の回数 + 1)+ 旧 Pod の終了 × 再実行の回数 + バックオフの合計」です。バックオフは指数バックオフで、10 秒、20 秒、40 秒…と伸びます(上限は 10 分) 7 。3 回作り直せば合計 70 秒です。再開点を Pod の外に持っていれば、2 回目以降の処理時間は短くなります。
なお、Job の restartPolicy には Never と OnFailure があります。OnFailure は、コンテナが失敗したときに同じ Pod の中で再起動するだけです。ドレインや退避で Pod そのものが消える場合には効かず、代替 Pod は restartPolicy によらず Job コントローラーが作ります 7 。podFailurePolicy を使うなら、Never が必須です。また、期限に達して Failed になった Job が、自動で再実行されることはありません 7 。期限で止まった仕事をやり直すには、次の CronJob の実行など、Job の外の仕組みが必要です。
バッチ処理:再開点を
再開点が無ければ、代替 Pod は最初からやり直しです。数時間かかる処理なら、途中経過を外部のストレージやデータベースに記録し、代替 Pod がそこから再開できるようにします。
処理を分割できるなら、インデックス付きJob と backoffLimitPerIndex(v1.33 で stable)で、やり直しをインデックス単位に絞れます。CronJob では concurrencyPolicy で、前回と重なったときに今回を飛ばす(Forbid)か置き換える(Replace)かを決めます。既定の Allow は同時に動かします 6 。
ステートフルな
ここまでの設計は「状態を Pod の外に出せば、止まっても再開できる」という前提に立っています。状態を Pod の中に溜めること自体が仕事のサービスでは、この前提が成り立ちません。このセクションは、僕の実務経験ではなく、kind の検証環境で 2 回確かめた範囲の話です。
tail sampling の
OpenTelemetry Collector の tail sampling は、trace の span をメモリに溜めてから残すかどうかを判定します。そのため同じ trace の span は、すべて同じ Collector に届く必要があります 17 。複数台にするときは、前段に loadbalancing exporter を置いて traceID で送り先を決めます 18 。
Collector は 2 段の構成にしました。前段のフロントが 1 台(loadbalancing exporter、DNS で送り先を解決)、後段で tail sampling を行うバックエンドが 2 台です。Go で書いた trace の生成器から 20 本の trace をそれぞれ 30 秒かけて送り、開始 12 秒後にバックエンドを 1 台削除しています。削除したバックエンドは Deployment が作り直すので、その後に代替のバックエンドが 1 台加わります。
| 1 回目 | 2 回目 | |
|---|---|---|
| 届いた span / 送った span | 598 / 620 | 580 / 620 |
| 複数のバックエンドに分断された trace | 16 / 20 | 15 / 20 |
件数は削除のタイミングで変わり、2 回の実行でも違う値になりました。実際のクラスターでも同じ数にはならないはずです。一方で、分断の形は 2 回とも同じでした。削除されたバックエンドに届いていた trace は、どれも次の図の形で分断されています。
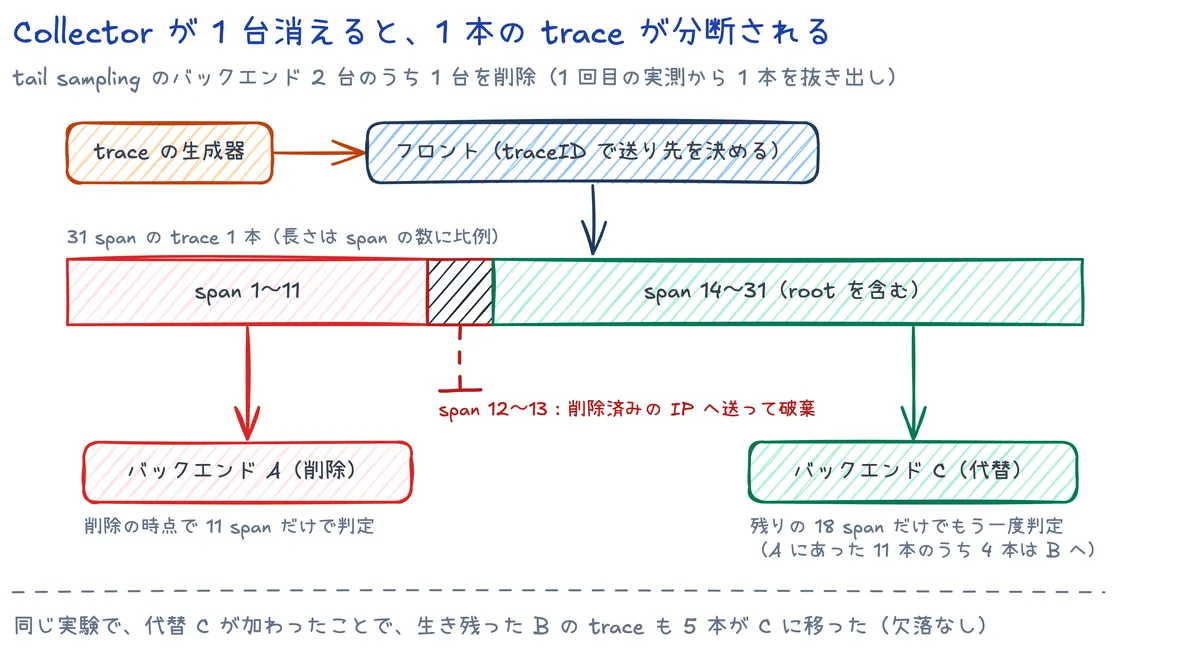
1 本の trace が 2 つのバックエンドでどちらも不完全なまま判定されています。途中の span が欠落したのは、削除の直後もフロントが削除済みの IP へ送り続け、送れずに破棄したためです。削除されたバックエンドの終了処理は 3〜4 ミリ秒で終わっていたので、猶予期間を延ばしても結果は変わらないはずです(延ばした場合は試していません)。分断はそれだけでは済みませんでした。代替のバックエンドが加わったことで、生き残ったバックエンドに届いていた trace も、各回 5 本ずつ送り先が変わって分断されています(こちらは span の欠落なし)。
loadbalancing exporter の README によると、送り先の一覧が変わると、およそ R/N の経路が別の送り先に移ります 19 。R は経路の総数、N は送り先の数です。
Consolidation でバックエンドの Pod が別のノードへ移る場合も、同じことが起きるはずです。フロントから見れば、「1 台消える」と「1 台加わる」が続けて起きるからです(Karpenter 上では試していません)。今回の実測からすると、分断が起きるタイミングは 2 つです。アプリ側の停止処理で防ぐ手段は見つからなかったので、Disruption の機会そのものを減らすしかないと考えています。たとえば、Collector を Consolidation の対象外のノードに置く方法や、do-not-disrupt を付ける方法です。ただ、これらの対策は検証していません。
プラットフォーム側の
保護の
| 手段 | 効く範囲 | 補足 |
|---|---|---|
| PDB | Eviction API を通る退避 | Karpenter では、1 つでも止めるとノード全体が Consolidation の対象外になる |
| do-not-disrupt(Pod) | Consolidation、条件付きで Drift | "true" は無期限、"30m" は期間指定 |
| disruption budget(NodePool) | graceful の流量 | 既定は nodes: 10% |
NodePool の terminationGracePeriod は、ドレインが続く時間の上限です。上限に間に合うよう、PDB や do-not-disrupt の Pod も、Pod 自身の猶予期間を見込んで前もって強制的に削除されます 20 。猶予期間が上限より長い Pod は、ドレインの開始と同時に、猶予を上限までの残り時間に縮めて削除されます(KWOK では、猶予期間 300 秒の Pod が上限 30 秒のノードで 29 秒に縮められました)。
なお consolidationPolicy は、v1 で WhenUnderutilized が WhenEmptyOrUnderutilized に改名され、v1.14 で Balanced が加わっています。古い記事の設定例はそのままでは使えません。
保護しすぎた
do-not-disrupt が有効な Pod(期間内で、まだ終了していない Pod)が載ったノードは、Consolidation の対象から外れます。東京リージョンの m7g.xlarge(4 vCPU・16GiB、Linux、オンデマンド)は、2026 年 10 月時点で 0.2108 USD/時間です。1 ドル 160 円、720 時間(30 日)で計算すると、1 台あたり月およそ 2 万 4 千円 になります。
Consolidation には、ノードを丸ごと消す Deletion と、安いノードに置き換える Replace があります。do-not-disrupt の Pod 1 つによって Deletion できないノードがあれば、最大でこの額を払い続けることになります(Replace なら差額分です)。なお Spot はオンデマンド比で最大 90% 安くなりますが 21 、そのぶん Interruption の機会も増えます。結局、アプリが Disruption に強いことが、安いノードを使う前提条件になります。
bin-packing と
ノードの集約率もコストに効きます。Karpenter は bin-packing を前提にノードを起動しますが、Pod を実際に配置するのは kube-scheduler です。kube-scheduler の既定(LeastAllocated)は Pod を分散させるので、集約率が下がります。その結果、Consolidation が Pod の再配置とノードの削除を繰り返すことになります 22 。
Karpenter のドキュメントが勧めるのは、kube-scheduler の採点方式を MostAllocated に変えることです。集約率が上がってコストが下がり、Consolidation による再配置も減ります。ただし Pod が少数のノードに集まるぶん、requests より limits を大きくした Pod はバーストの余地が減り、ノード障害の影響も少数のノードに集中します。
do-not-disrupt には
do-not-disrupt が向く対象もあります。ドキュメントは、止められたら最初からやり直しになる機械学習のような長いバッチ Job を例に挙げています。tail sampling の Collector も候補ですが、常駐するので期限を決めにくく、どう保護するかは今回検証していません。Job については、"true" で無期限に保護すると、ハングした Job のせいでノードが空かなくなります。そこで Job には、次の 2 つを組み合わせるのがよいと考えています。
- do-not-disrupt を期間指定(例
"2h")にして、プラットフォームが待つ保護の期間を区切る - Job に
activeDeadlineSecondsを付けて、アプリが動いてよい期限を決める
ただし 2 つの時計はそろいません。do-not-disrupt の期間は Pod が動き始めてから数えるので、代替 Pod では最初から数え直します。一方、activeDeadlineSeconds は Job の開始から数え続けます 1 。
ドキュメントは期間指定の狙いを、長時間動く Pod や異常な Job がクラスターの運用を止め続けないようにするためと説明していますが、activeDeadlineSeconds との組み合わせには触れていません。この組み合わせは僕の考えで、Karpenter 上では検証していません。
まとめ
アプリ側の責務
SIGTERMを受けたら新しいタスクを取らず、処理中のタスクを猶予期間内に片付ける。猶予期間は preStop と分け合う- Job では、仕事を終えずに止まるときに終了コードを 0 以外にする(ワーカーは 0 でよい)。
podFailurePolicyを設定した Job では、これが判定を左右する - 二重実行は起きる前提で冪等にする。ロックを使うなら fencing token と組み合わせる
- 長い処理は再開点を Pod の外に持つ
プラットフォーム側の設定
- Job には
podFailurePolicyでDisruptionTargetをIgnoreし、activeDeadlineSecondsで期限を付ける。Ignoreは condition が付いた失敗にしか効かず、kubelet による退避はアプリ側に原因があってもIgnoreされる - PDB と do-not-disrupt は最小限にし、do-not-disrupt は期間指定にする
- kube-scheduler を
MostAllocatedにして、Karpenter の bin-packing とそろえる - ステートフルなサービスは、Disruption の機会そのものを減らす設計を別に考える
いちばん大きかった学びは、ワーカー向けの終了コード 0 を Job でそのまま使うと、podFailurePolicy を設定した場合に、未完了の仕事が「完了」として扱われてしまうことでした。同じ Go のコードを使い回していると、気づきにくい落とし穴です。アプリ側の責務を先に果たし、プラットフォーム側の設定はその上で最小限にする。この順で考えると、Disruption に耐えながらノードのコストも抑えられます。
それでは、またね。
footnote
-
Disruption | Karpenter (v1.15 を参照) ↩ ↩2
-
kubernetes-sigs/karpenter pkg/controllers/node/termination/terminator/eviction.go (通常の退避は Eviction API、
forceDeleteはkubeClient.Delete) ↩ -
kubernetes/kubernetes#141316 (eviction API を通らない削除と DisruptionTarget) ↩
-
Job | Kubernetes API Reference (JobStatus の startTime) ↩
-
kubernetes/kubernetes pkg/controller/job/job_controller.go (
getNewFinishedPodsは Pod が失敗したかどうかだけで選び、その結果をバックオフの記録に渡す) ↩ -
kubernetes/kubernetes#130881 (自動で close されたまま、修正はされていない) ↩
-
Scheduling | Karpenter (kube-scheduler settings) ↩